Xây dựng Vietfuel API phiên bản ít RAM

toidicakhia
@toidicakhia
Vào một ngày đẹp trời, khi tôi lướt trên Facebook, tình cờ tôi nhìn thấy được 1 bài viết đến từ cộng đồng J2Team…
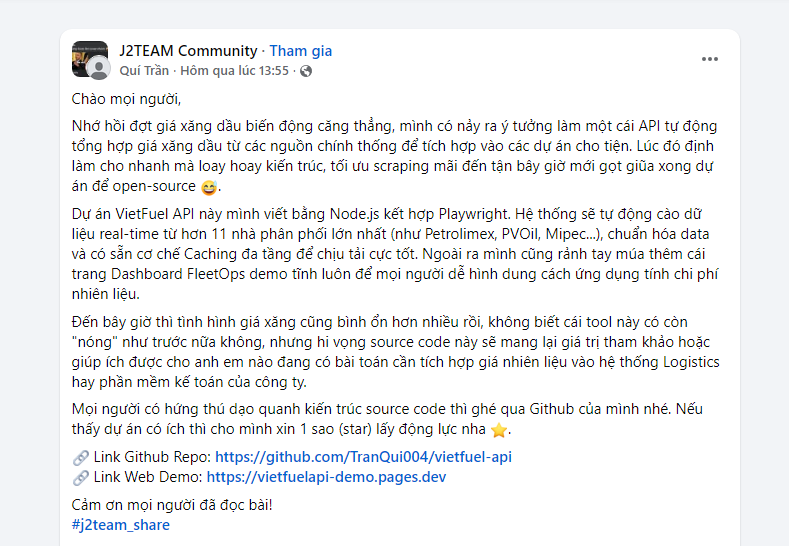
Điều đầu tiên tôi đập mắt vào tool này là ở 1 framework rất tốn RAM: Playwright. Playwright là 1 thư viện cho phép điều khiển trình duyệt thật (Chromium, Firefox, WebKit) để chạy automation — rất giống Selenium. Nó cực kỳ hữu ích khi cần scrape các website có độ bảo mật cao như Google, Facebook, vì chúng render nội dung bằng JavaScript phía client.
Tuy nhiên, các website liên quan đến xăng dầu ở Việt Nam thường không có bảo mật phức tạp. Chúng ta hoàn toàn có thể reverse engineer các API của họ mà không cần khởi động cả một trình duyệt ngốn hàng trăm MB RAM. Trong bài viết này, tôi sẽ hướng dẫn anh em cách reverse các API của một số nhà cung cấp xăng dầu ở Việt Nam. Let’s go!
Chuẩn bị
Trước khi bắt đầu, chúng ta cần cài đặt các thư viện cần thiết:
pip install aiohttp bs4 lxml1. Comeco
Website Comeco (comeco.vn) rất đơn giản — không có bảo mật, không có API riêng. Toàn bộ dữ liệu giá xăng được render thẳng vào HTML, nên chúng ta sẽ dùng BeautifulSoup để parse.
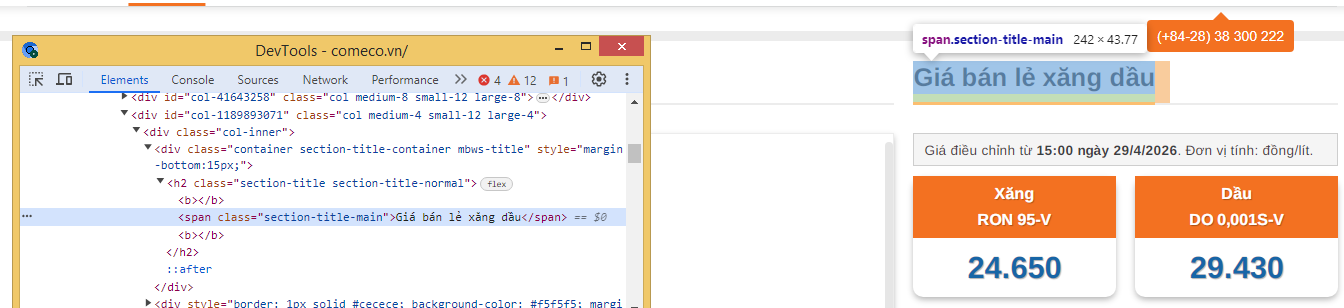
Giá xăng dầu bắt đầu bằng tiêu đề “Giá bán lẻ xăng dầu”. Ta dùng nó làm điểm neo để tìm đúng section cần lấy:
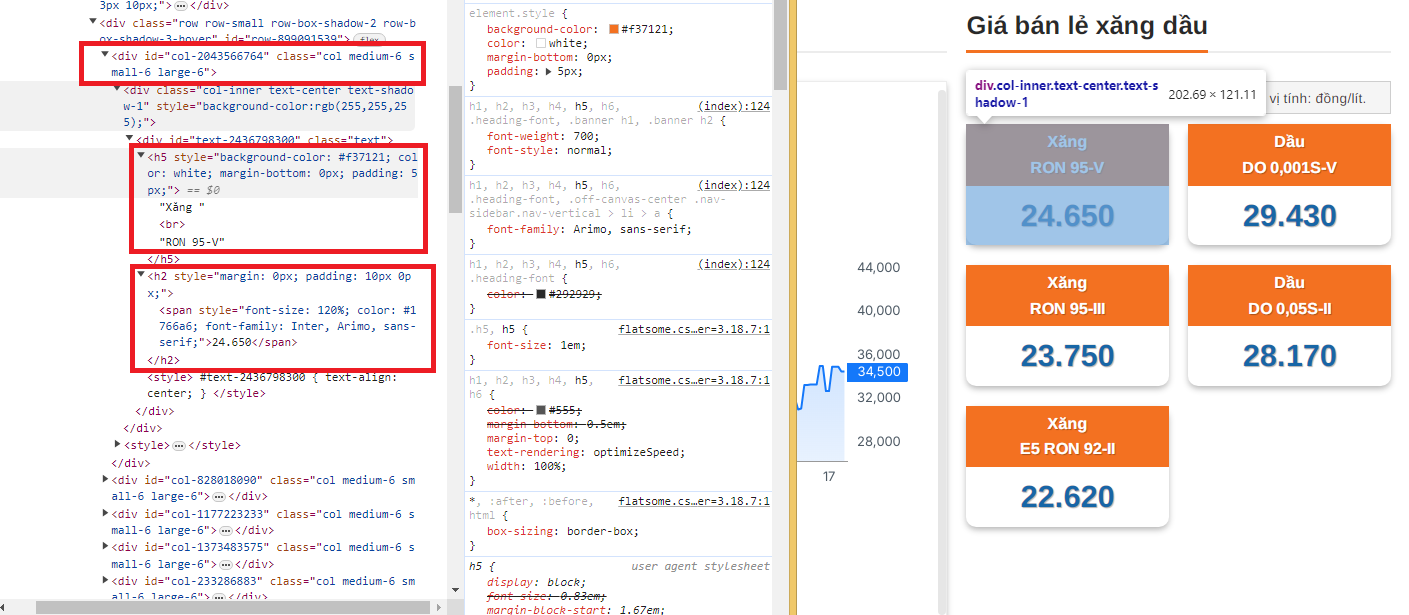
heading = soup.find("span", class_="section-title-main", string="Giá bán lẻ xăng dầu")Quan sát tiếp vào tab Elements, ta thấy 1 đoạn code có id=row-<number>. Mở đoạn code bên trong element đó, ta thấy các element có tag div và chứa thuộc tính id=col-<number> với class giống nhau. Kiểm tra lần lượt, ta thấy mỗi element có:
- 1 tag
h5chứa tên loại xăng - 1 tag
spanbên trongh2chứa giá tiền
Ta có code hoàn chỉnh:
async with aiohttp.ClientSession() as session:
    async with session.get("https://comeco.com.vn/") as resp:
        html = await resp.text()

soup = BeautifulSoup(html, "lxml")

heading = soup.find("span", class_="section-title-main", string="Giá bán lẻ xăng dầu")
if heading:
    section = heading.find_parent("div", class_="col-inner")
    cols = section.select(".col-inner")

    for col in cols:
        h5 = col.find("h5")
        h2 = col.find("h2")
        if not h5 or not h2:
            continue

        product = h5.get_text(separator=" ", strip=True)
        price_text = h2.get_text(strip=True).replace(".", "")
2. Petrotimes
Website Petrotimes (petrotimesgroup.com) cũng không có bảo mật. Ta bật F12 và vào thử website:
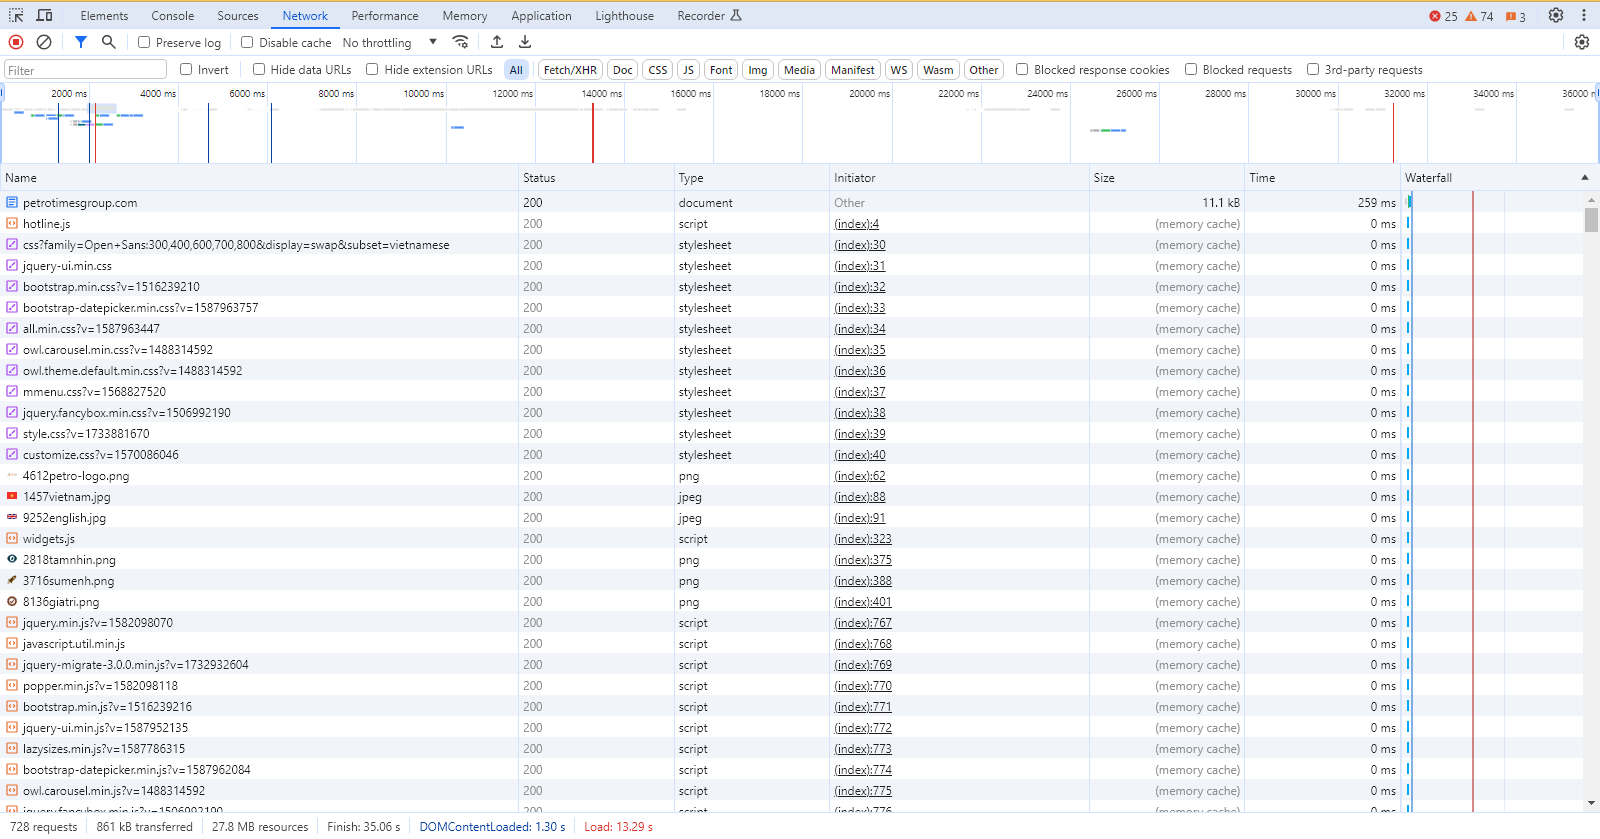
Mở tab Fetch/XHR, ta thấy có 2 API liên quan đến giá: get-petro và get-price. Ta mò vào API đầu tiên:
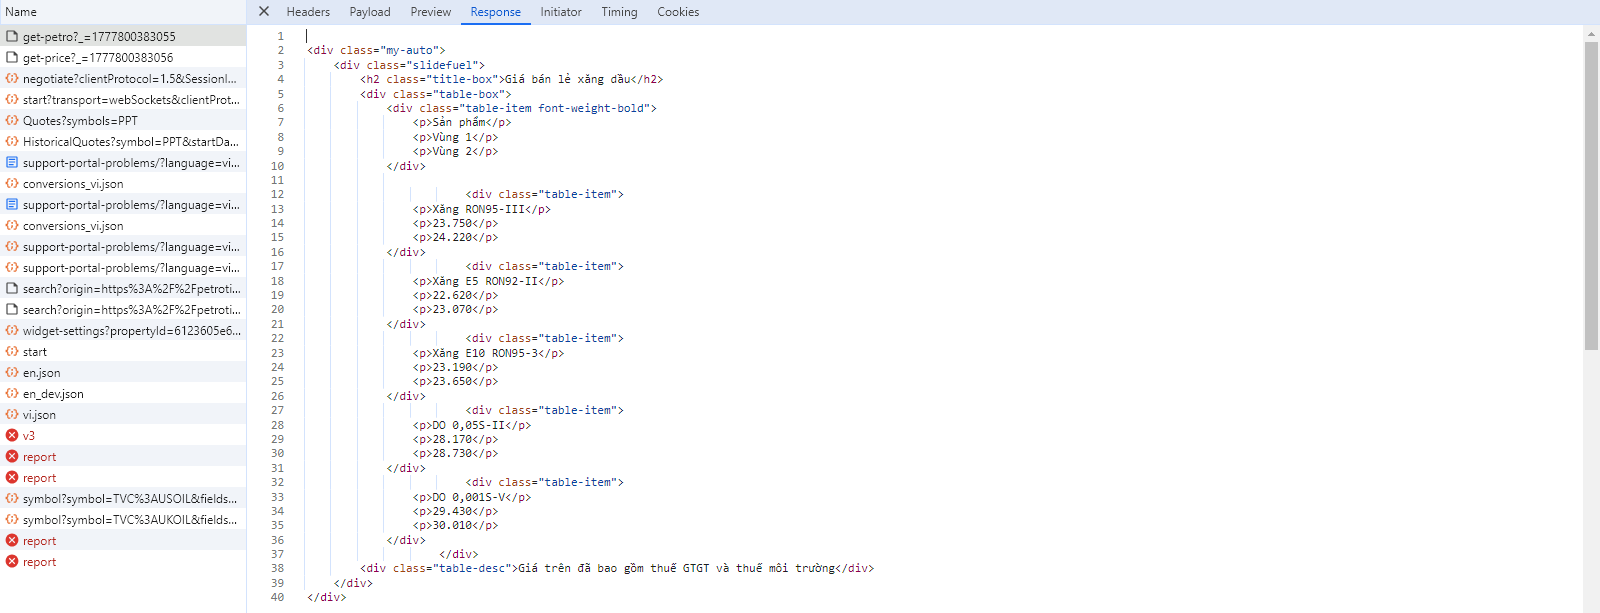
Response trả về là HTML, trong đó chứa một bảng giá xăng dầu được render sẵn. Cấu trúc HTML khá đơn giản: mỗi dòng giá là một div.table-item, bên trong có nhiều tag p chứa tên sản phẩm và giá theo từng vùng.
Lưu ý: các div.table-item có class font-weight-bold là header row (dòng tiêu đề), cần bỏ qua.
async with aiohttp.ClientSession() as session:
    async with session.get("https://petrotimesgroup.com/site/get-petro") as resp:
        html = await resp.text()

soup = BeautifulSoup(html, "lxml")
items = soup.find_all("div", class_="table-item")

for item in items:
    if "font-weight-bold" in item.get("class", []):
        continue

    paragraphs = item.find_all("p")
    if len(paragraphs) >= 3:
        name = paragraphs[0].get_text(strip=True)
        zone1 = paragraphs[1].get_text(strip=True)
        zone2 = paragraphs[2].get_text(strip=True)
3. Saigonpetro
Ta bật F12 và truy cập vào bảng giá của SaigonPetro:
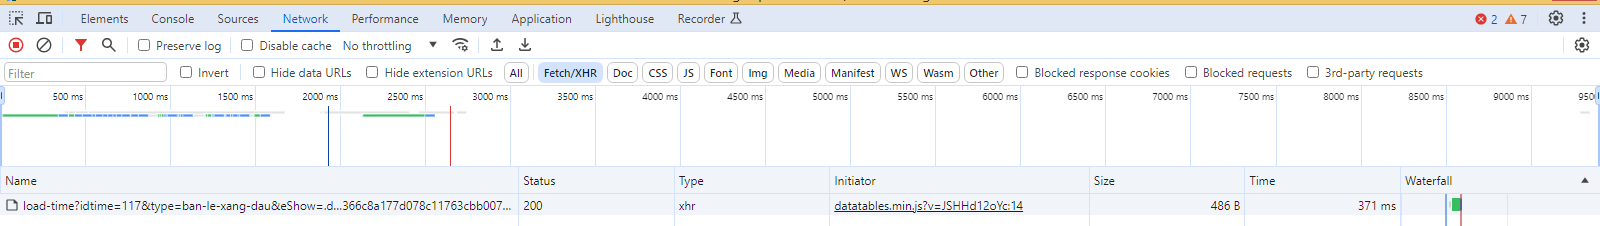
Ta lại thấy API trả về một HTML giống như Petrotimes:
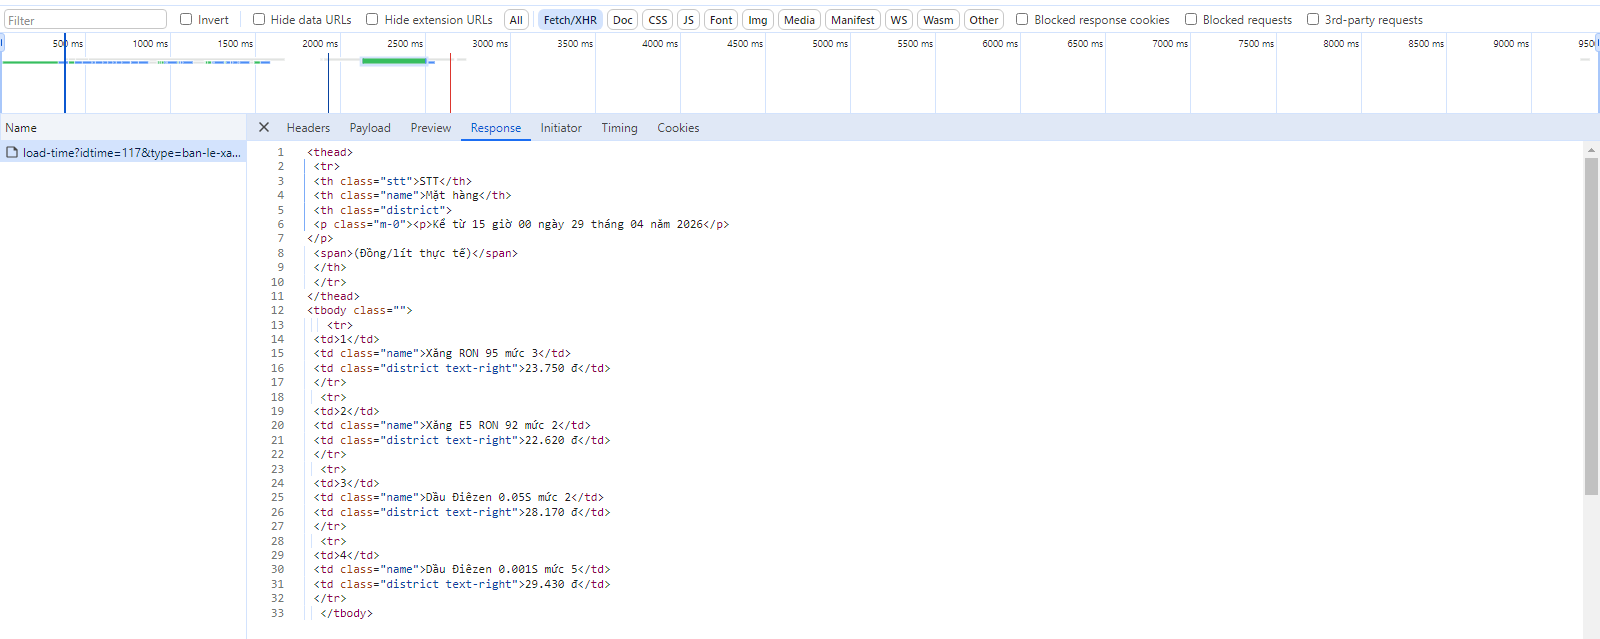
Tuy nhiên chúng ta có 1 vấn đề: param idtime trong URL là một con số động — nó thay đổi theo từng kỳ cập nhật giá. Nếu hardcode con số này, API sẽ trả về dữ liệu cũ hoặc lỗi sau khi giá được cập nhật.
Thử tìm kiếm giá trị đó trên source:
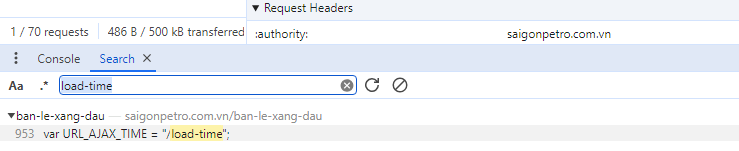
Phát hiện API đó ở trong file HTML, ta thử click vào nó:
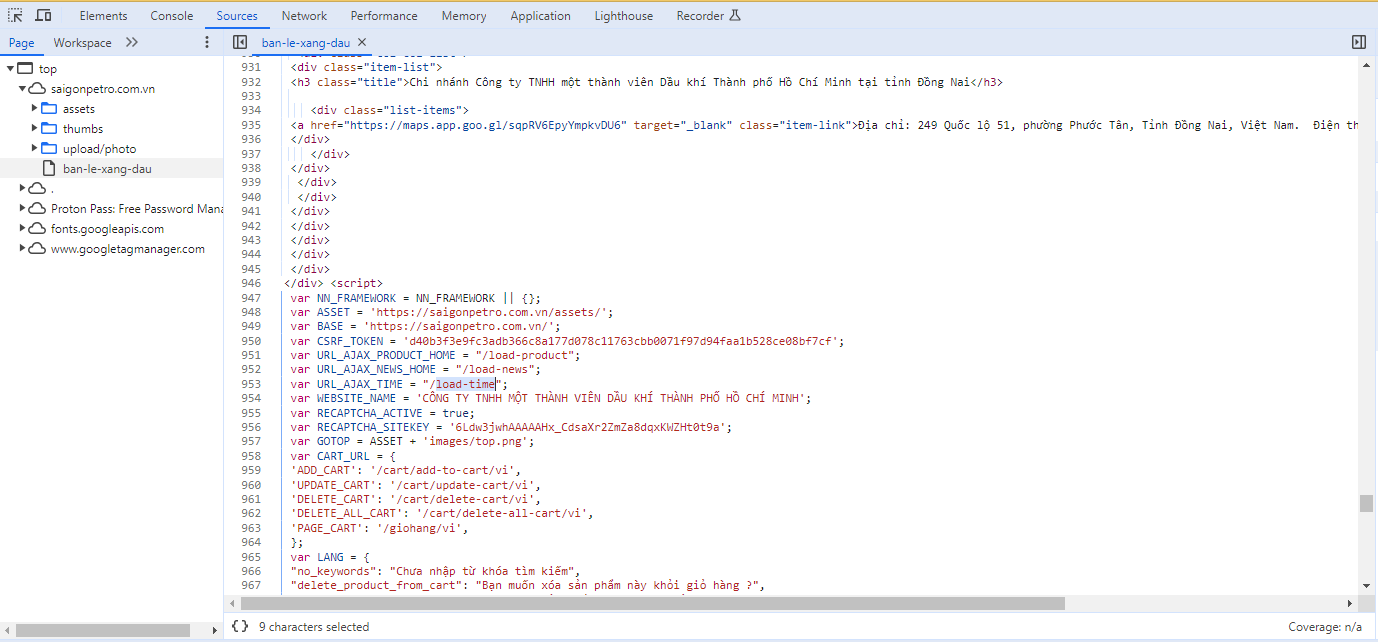
Thử tìm kiếm trên page, nhưng nó chỉ có 1 kết quả tại page. Ta thử tìm kiếm toàn bộ:
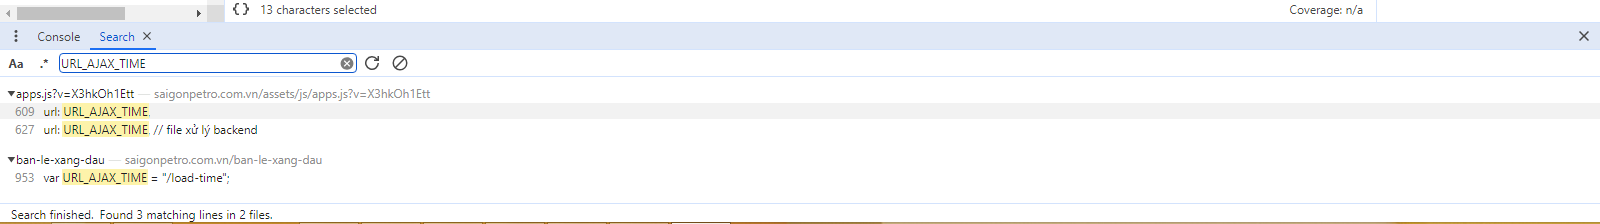
Có tận 3 kết quả, đồng thời có 2 kết quả từ 1 file Javascript. Click vào kết quả đó, ta thấy rõ 1 đoạn call API:
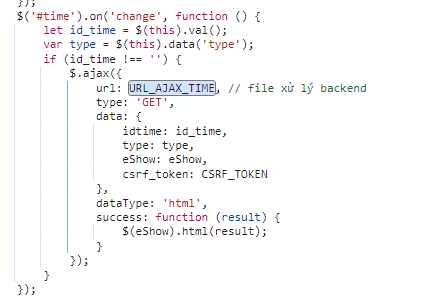
Ta phát hiện ra đoạn call API chỉ được gọi khi tag có id="time" thay đổi. Đây là một <select> dropdown cho phép người dùng chọn kỳ giá. Giá trị idtime hiện tại được lưu trong thuộc tính data-list của tag đó. Ta tìm kiếm trên tab Elements:
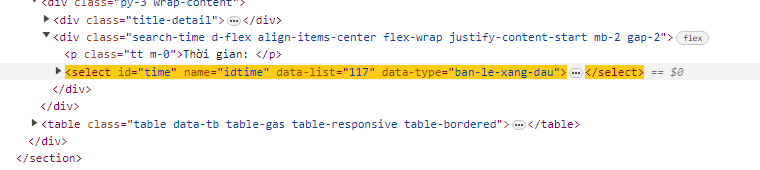
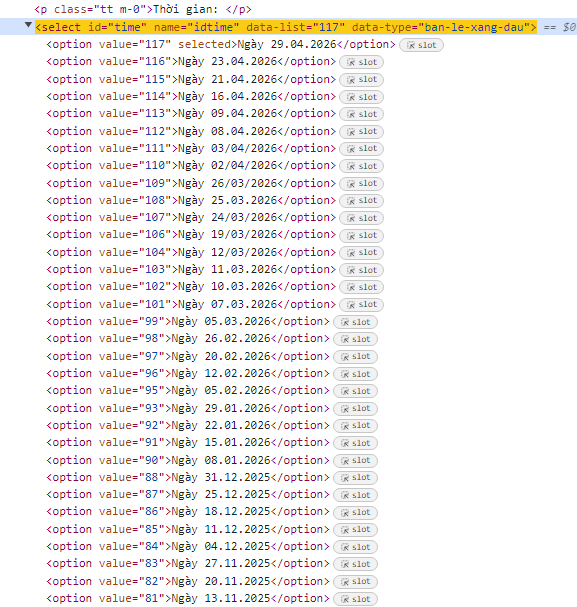
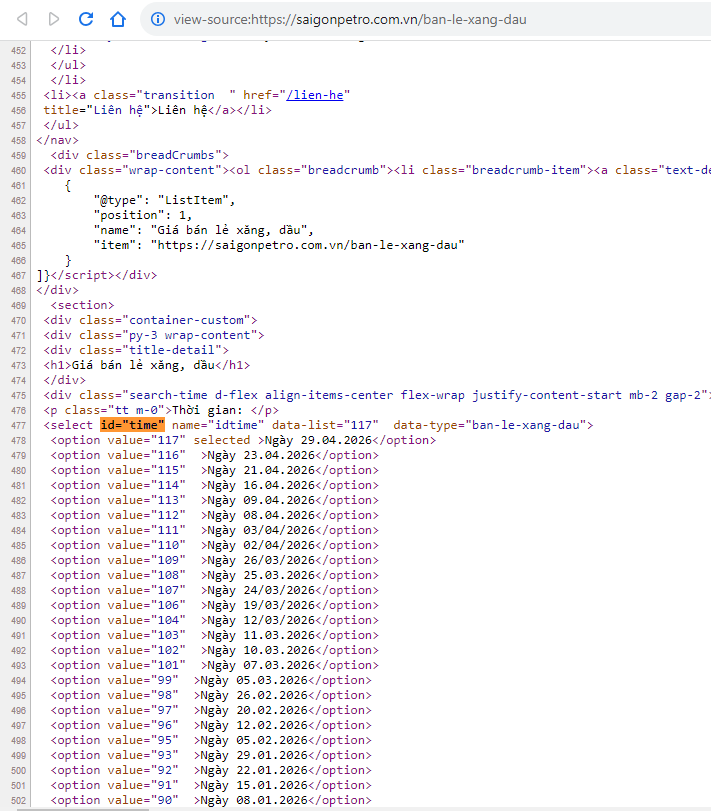
Ta triển khai code như sau:
session = aiohttp.ClientSession()

async with session.get("https://saigonpetro.com.vn/ban-le-xang-dau") as resp:
    html = await resp.text()

soup = BeautifulSoup(html, "lxml")

select_tag = soup.find("select", id="time")
data_list = select_tag.get("data-list") if select_tag else None

if not data_list:
    return

url = f"https://saigonpetro.com.vn/load-time?idtime={data_list}&type=ban-le-xang-dau&eShow=.data-tb"
async with session.get(url) as resp:
    prices_html = await resp.text()

soup = BeautifulSoup(prices_html, "lxml")

for row in soup.find("tbody").find_all("tr"):
    cols = row.find_all("td")
    if len(cols) >= 3:
        name = cols[1].get_text(strip=True)
        price = cols[2].get_text(strip=True).replace(",", ".").replace(" đ", "")
4. Mipecorp
Đây là trường hợp thú vị. Khi truy cập mipecorp.com.vn lần đầu tiên, server không trả về trang thật ngay mà trả về một đoạn JavaScript nhỏ để set cookie trước, sau đó mới redirect về trang thật. Đây là kỹ thuật chống bot đơn giản.

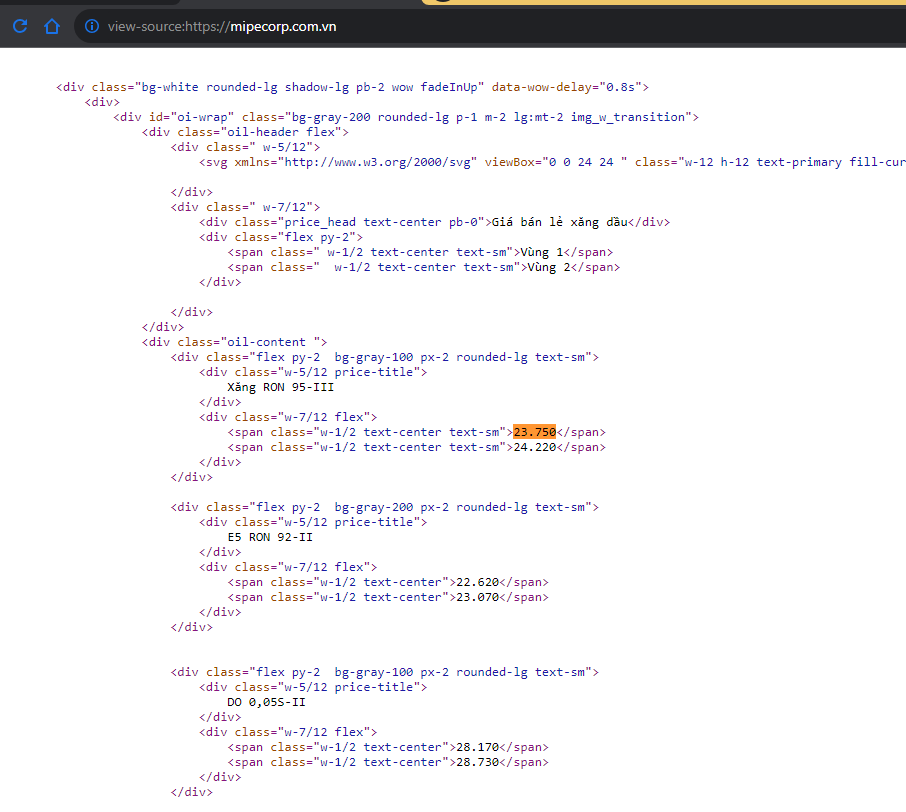
Tuy nhiên, cookie này có thời hạn đến năm 2099 (không phải typo). Điều đó có nghĩa là:
- Chúng ta chỉ cần lấy cookie một lần duy nhất bằng cách mở trình duyệt thật vào trang đó
- Mọi request sau đó đều dùng cookie này, không cần làm lại
Để lấy cookie, mở DevTools → tab Application → Cookies → copy giá trị D1N.
async with aiohttp.ClientSession() as session:
    async with session.get("https://mipecorp.com.vn/", headers={"Cookie": f"D1N={cookie_value}"}) as resp:
        html = await resp.text()

soup = BeautifulSoup(html, "lxml")
oil_contents = soup.find_all("div", class_="oil-content")

if oil_contents:
    for row in oil_contents[0].find_all("div", class_="price-title"):
        name = row.text.strip()
        prices = [s.text.strip() for s in row.find_parent().find_all("span")]

        if len(prices) >= 2:
            zone_1_price = prices[0]
            zone_2_price = prices[1]
5. PVOil
Đây là case thú vị nhất. PVOil chủ động dùng Cloudflare để bảo vệ trang web — mọi request đến domain pvoil.com.vn đều đi qua Cloudflare trước, và Cloudflare sẽ chặn các bot không có browser fingerprint hợp lệ.
Các bạn nghĩ đến đây là bó tay rồi nhỉ? Tôi thử tra cứu DNS history của website này:
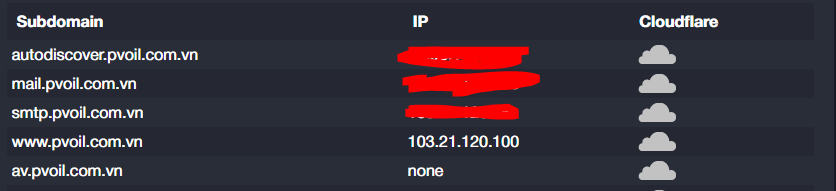
Và tôi đã tìm ra được địa chỉ IP gốc mà PVOil đặt server — tức là IP trước khi họ bật Cloudflare. Tiến hành truy cập thẳng vào IP này:
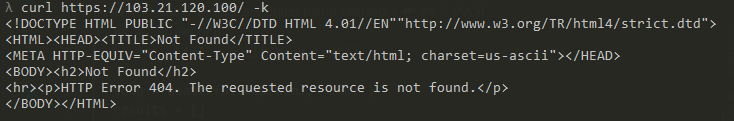
Tại sao lại ra trang lỗi, trong khi vào bằng domain lại được? Câu trả lời nằm ở cách Reverse Proxy hoạt động.
Hầu hết các máy chủ sử dụng Reverse Proxy như Nginx, Apache, hay IIS (trường hợp của PVOil). Các phần mềm này dùng HTTP header Host để xác định website nào cần phục vụ — vì một server có thể host nhiều website trên cùng một IP. Khi ta truy cập thẳng bằng IP, header Host mặc định là địa chỉ IP đó, không khớp với bất kỳ virtual host nào nên server trả về trang lỗi mặc định.
Giải pháp: truyền thủ công header Host: www.pvoil.com.vn vào request.
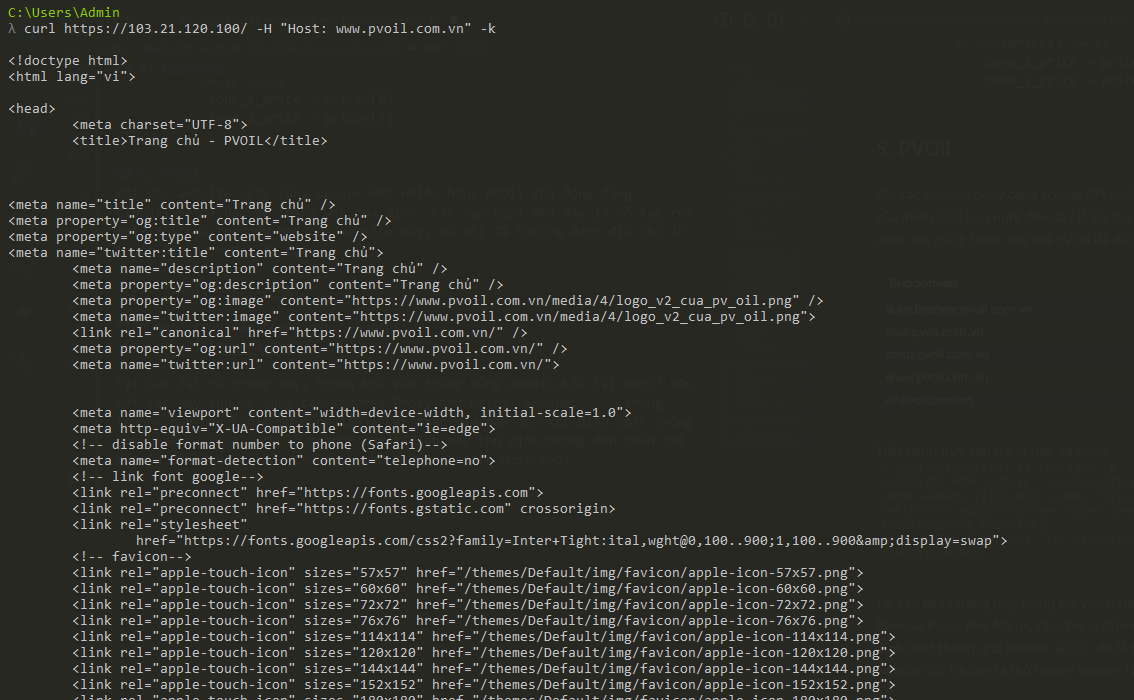
Tuyệt, ta đã thấy trang chủ! Giờ chúng ta có thể truy cập vào tài nguyên của website mà không qua Cloudflare. Truy cập vào trang tin giá xăng dầu:
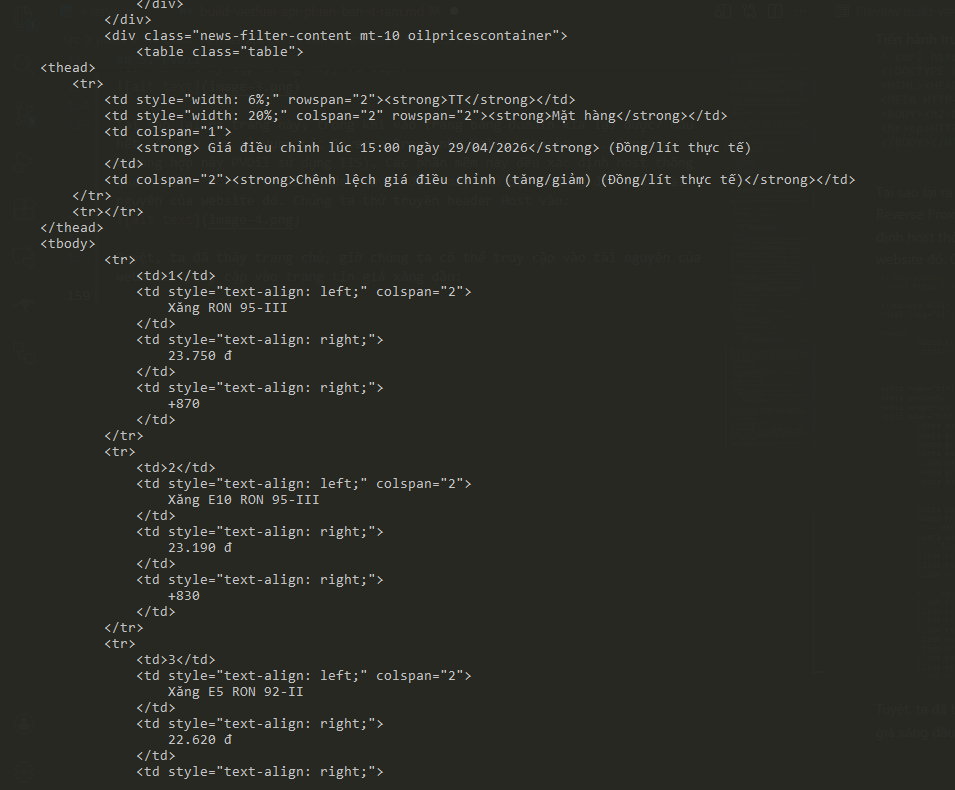
async with aiohttp.ClientSession() as session:
    async with session.get(f"https://103.21.120.100/api/oilprice/load-view", headers={"Host": "www.pvoil.com.vn",}, ssl=False) as resp:
        html = await resp.text()

soup = BeautifulSoup(html, "lxml")

for row in soup.select("tbody tr"):
    cols = [td.get_text(strip=True) for td in row.find_all("td")]
    if len(cols) >= 2:
        name = cols[0]
        zone_1_price = cols[1]
        zone_2_price = cols[2] if len(cols) >= 3 else None
Lưu ý bảo mật:
ssl=Falsebỏ qua xác thực certificate. Điều này chấp nhận được trong trường hợp này vì ta đang truy cập IP nội bộ đã biết trước, không phải kết nối ra internet tùy ý.
6. Petrolimex
Đây là website khó nhất trong danh sách. Phần giá xăng dầu trên giao diện được cập nhật qua WebSocket — tức là dữ liệu được đẩy real-time từ server xuống client, không có request HTTP thông thường nào để bắt trong tab Fetch/XHR.
Tuy nhiên, tôi tình cờ tìm được 1 gist trên Github dẫn đến một REST API cố định của Petrolimex — có vẻ đây là API nội bộ dùng cho CMS của họ, và nó không yêu cầu authentication.
URL API được encode base64 trong query param x-request, chứa các filter để lấy đúng danh mục giá xăng dầu:
PETROLIMEX_API = "https://portals.petrolimex.com.vn/~apis/portals/cms.item/search?x-request=eyJGaWx0ZXJCeSI6eyJBbmQiOlt7IlN5c3RlbUlEIjp7IkVxdWFscyI6IjY3ODNkYzEyNzFmZjQ0OWU5NWI3NGE5NTIwOTY0MTY5In19LHsiUmVwb3NpdG9yeUlEIjp7IkVxdWFscyI6ImE5NTQ1MWUyM2I0NzRmZTU4ODZiZmI3Y2Y4NDNmNTNjIn19LHsiUmVwb3NpdG9yeUVudGl0eUlEIjp7IkVxdWFscyI6IjM4MDEzNzhmZTFlMDQ1YjFhZmExMGRlN2M1Nzc2MTI0In19LHsiU3RhdHVzIjp7IkVxdWFscyI6IlB1Ymxpc2hlZCJ9fV19LCJTb3J0QnkiOnsiTGFzdE1vZGlmaWVkIjoiRGVzY2VuZGluZyJ9LCJQYWdpbmF0aW9uIjp7IlRvdGFsUmVjb3JkcyI6LTEsIlRvdGFsUGFnZXMiOjAsIlBhZ2VTaXplIjowLCJQYWdlTnVtYmVyIjowfX0"

async with aiohttp.ClientSession() as session:
    async with session.get(PETROLIMEX_API) as resp:
        raw = await resp.text()

data = json.loads(raw)

for item in data.get("Objects", []):
    name = item.get("Title", "")
    english_name = item.get("EnglishTitle", "")
    zone1_price = item.get("Zone1Price")
    zone2_price = item.get("Zone2Price")
Kết luận
Không cần tốn vài trăm MB RAM để chạy Playwright, chúng ta vẫn có thể xây dựng API đầy đủ một cách dễ dàng. Toàn bộ stack chỉ cần khoảng 50–80 MB RAM khi chạy, và có thể cập nhật giá liên tục với tần suất cao tùy nhu cầu.
Cảm ơn anh em đã xem bài viết!
Bonus: Anh em có thể ghé qua https://fuelprice.toidicakhia.me/ để theo dõi biến động giá nhé.